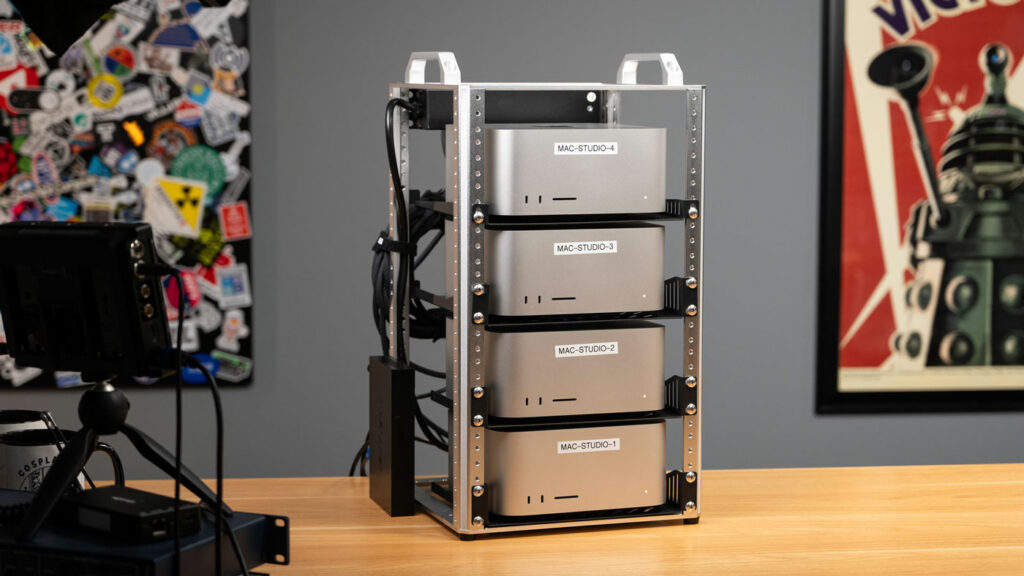
Depuis décembre 2025, Apple a activé une possibilité sortant de l’ordinaire : relier plusieurs Mac en Thunderbolt 5 pour répartir l’exécution de modèles d’intelligence artificielle.
Au centre de cette architecture se trouve le RDMA, pour Remote Direct Memory Access. Cette technologie permet à deux machines d’échanger des données avec une latence beaucoup plus faible qu’une communication réseau traditionnelle.
L’idée peut sembler simple : connecter plusieurs Mac pour cumuler leur puissance et leur mémoire. Dans la pratique, leur coopération demande une organisation complexe. Plusieurs Mac reliés en RDMA ne deviennent pas un seul ordinateur géant, et quatre machines ne travaillent pas nécessairement quatre fois plus vite.
Le RDMA change néanmoins les possibilités offertes par les Mac équipés de Thunderbolt 5. Il devient envisageable de charger des modèles trop volumineux pour une seule machine, puis de distribuer leurs calculs entre plusieurs ordinateurs.
En bref
- RDMA signifie Remote Direct Memory Access.
- Cette technologie réduit les copies de données et les interventions du système pendant les communications entre machines.
- Apple prend en charge le RDMA sur les Mac Apple Silicon équipés de Thunderbolt 5 à partir de macOS 26.2.
- MLX utilise le moteur JACCL(1) pour communiquer en RDMA par Thunderbolt.
- Le RDMA offre une latence nettement inférieure à une communication TCP/IP classique.
- Plusieurs Mac peuvent partager l’exécution d’un modèle, mais leur mémoire reste physiquement séparée.
- Quatre machines nécessitent six câbles Thunderbolt pour former le maillage complet demandé par JACCL(1).
- Apple annonce jusqu’à trois fois les performances d’un seul Mac Studio avec un cluster de quatre machines.
- Cette architecture s’adresse surtout à l’IA, à la recherche et au calcul distribué.
Comment deux ordinateurs échangent normalement des données
Dans une communication réseau traditionnelle, une application prépare des données en mémoire, puis demande au système d’exploitation de les transmettre.
Ces données doivent généralement traverser plusieurs couches :
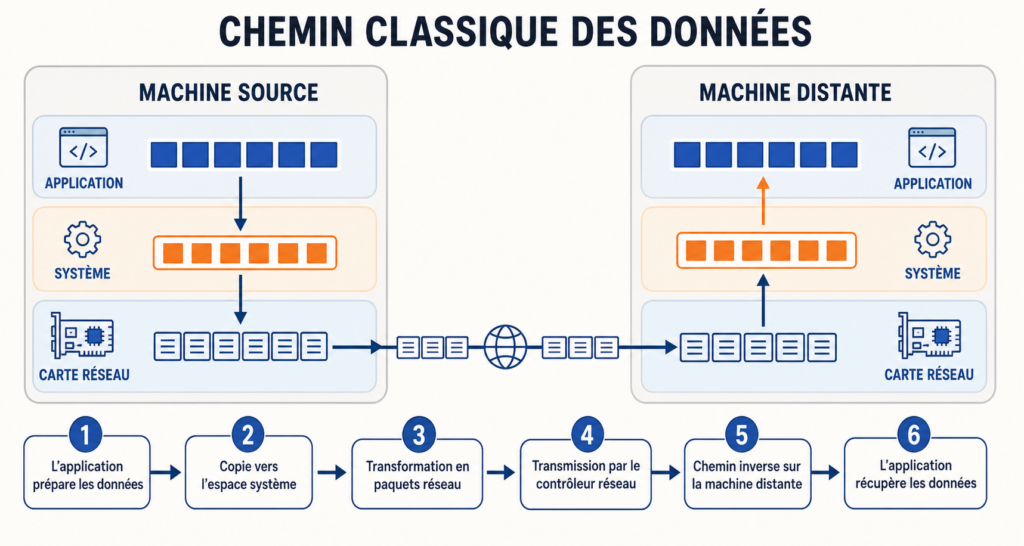
Ces opérations sont parfaitement adaptées à la navigation web, au partage de fichiers et à la plupart des services réseau. Elles deviennent toutefois coûteuses lorsqu’un programme doit échanger continuellement de grands tableaux de nombres entre plusieurs machines.
Chaque copie consomme du temps, de la bande passante mémoire et des ressources CPU. La pile réseau ajoute également de la latence.
Pour un modèle d’intelligence artificielle réparti entre plusieurs ordinateurs, ces délais se répètent à chaque étape du calcul. Ils peuvent finir par annuler une partie du gain obtenu grâce aux processeurs supplémentaires.
Ce que change le RDMA
Le RDMA permet à une machine de lire ou d’écrire dans une zone de mémoire préparée sur une autre machine, avec moins d’interventions du processeur et du système d’exploitation.
Le chemin suivi par les données devient plus direct :
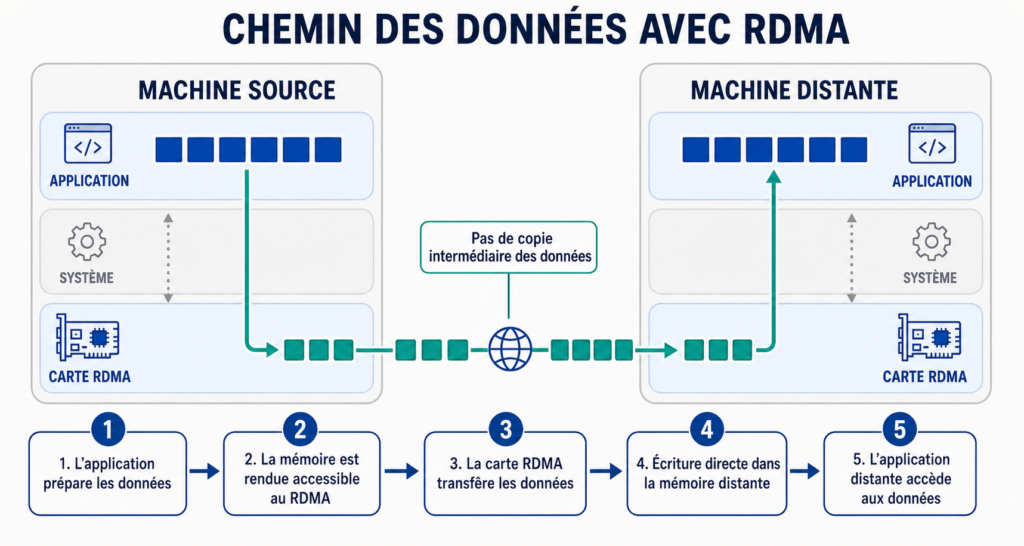
Le terme « accès direct » peut prêter à confusion. Une machine ne parcourt pas librement toute la mémoire d’un autre Mac. Les logiciels doivent enregistrer et préparer les zones qui pourront participer aux échanges.
Le RDMA fournit donc un mécanisme de transport très rapide, mais il appartient toujours à l’application de décider quelles données transmettre, à quel moment et vers quelle machine.
Pourquoi l’intelligence artificielle a besoin d’une faible latence
Un grand modèle de langage est composé de milliards de paramètres organisés en nombreuses couches. Pour produire une réponse, les données traversent successivement ces couches.
Lorsqu’un modèle est réparti entre plusieurs Mac, une machine effectue une partie du calcul, puis transmet ses résultats à la suivante. Ces échanges peuvent se produire plusieurs fois pour chaque token généré.
Une liaison rapide ne suffit pas. Elle doit aussi réagir avec une latence très faible.
Un transfert de grande taille peut exploiter efficacement une connexion à haut débit. La génération d’un token implique cependant de nombreux échanges plus petits, accompagnés de synchronisations. Si chaque communication ajoute un délai, toutes les machines finissent par attendre les autres.
Le RDMA cherche précisément à réduire ce temps d’attente.
La documentation de MLX indique que son moteur JACCL(1) obtient une latence environ dix fois inférieure à celle du moteur Ring(2) utilisant TCP/IP. Cette différence devient particulièrement importante pour le parallélisme de tenseurs, dans lequel les machines doivent communiquer très fréquemment.
Plusieurs formes de calcul distribué
Un modèle peut être réparti de différentes façons. Le choix dépend de son architecture, de sa taille et du nombre de machines disponibles.
Le parallélisme de pipeline
Avec le parallélisme de pipeline, chaque Mac reçoit un ensemble de couches du modèle.
Le premier traite le début du réseau, transmet le résultat au deuxième, puis les machines suivantes poursuivent le calcul.
Cette méthode ressemble à une chaîne de production. Elle permet de répartir un modèle très volumineux, mais certaines machines peuvent attendre que les précédentes aient terminé leur étape.
La latence de la liaison influence directement la vitesse de génération.
Le parallélisme de tenseurs
Le parallélisme de tenseurs découpe une même opération entre plusieurs machines. Chaque Mac calcule une partie d’une matrice, puis les résultats doivent être regroupés.
Cette approche peut mieux exploiter simultanément les différentes machines. Elle provoque cependant beaucoup plus de communications.
Le parallélisme de tenseurs exige donc une liaison rapide et surtout une très faible latence. C’est l’un des usages pour lesquels MLX considère le RDMA et JACCL comme nécessaires.
Le parallélisme de données
Le parallélisme de données confie une copie du modèle à chaque machine, puis leur envoie des données différentes.
Il est surtout utilisé pendant l’entraînement ou pour traiter de nombreuses requêtes indépendantes. Les machines travaillent plus longtemps seules et communiquent moins fréquemment.
Cette méthode augmente le débit global, mais ne permet pas nécessairement de charger un modèle trop volumineux pour la mémoire d’un seul Mac.
Les mémoires ne fusionnent pas réellement
Apple présente le RDMA comme un moyen de créer un vaste ensemble de mémoire partagé entre plusieurs Mac Studio.
Cette formulation décrit l’expérience proposée aux logiciels, mais les mémoires restent physiquement séparées.
Deux Mac Studio équipés de 512 Go ne se transforment pas en une machine possédant 1 To de mémoire unifiée. Chaque puce continue d’accéder beaucoup plus rapidement à sa propre mémoire locale.
Les parties du modèle doivent être réparties entre les machines. Lorsqu’un calcul a besoin d’une donnée située sur un autre Mac, celle-ci doit traverser la liaison Thunderbolt.
Cette différence est considérable :
- La mémoire locale du Mac Studio M5 Ultra atteint 1,2 To/s
- Thunderbolt 5 offre jusqu’à 120 Gbit/s dans certains modes
- La liaison externe reste donc très loin de la bande passante de la mémoire locale.
Le logiciel doit organiser le modèle de manière à limiter les échanges. Une mauvaise répartition peut conduire les processeurs à passer davantage de temps à attendre les données qu’à effectuer des calculs.
Thunderbolt 5 devient une interconnexion de cluster
Thunderbolt est généralement associé aux écrans, aux stations d’accueil et aux SSD externes. Avec le RDMA, il devient aussi une liaison directe entre ordinateurs.
Apple prend en charge le RDMA par Thunderbolt à partir de macOS 26.2 sur les Mac Apple Silicon équipés de Thunderbolt 5.
Cette compatibilité ne signifie pas que tous les logiciels savent automatiquement l’utiliser. Les applications doivent employer des bibliothèques capables de communiquer avec l’interface RDMA.
Dans l’écosystème Apple, MLX fournit le moteur JACCL. Son nom signifie Jack and Angelos’ Collective Communication Library. Il constitue l’équivalent, dans l’univers MLX, des bibliothèques de communication utilisées dans les clusters de GPU.
MLX propose aussi d’autres méthodes :
| Moteur | Transport | Usage |
| JACCL(1) | RDMA sur Thunderbolt 5 | Communications à très faible latence |
| Ring(2) | TCP/IP sur Thunderbolt | Configuration en anneau |
| Ring(2) | TCP/IP sur Ethernet | Solution plus simple et universelle |
| MPI(3) | Réseau traditionnel | Calcul distribué général |
| NCCL(4) | GPU Nvidia | Environnements CUDA |
JACCL est la solution la plus performante pour les échanges fréquents entre Mac, mais aussi la plus contraignante à mettre en place.
Pourquoi faut-il autant de câbles ?
JACCL demande actuellement une topologie entièrement maillée. Chaque Mac doit être relié directement à tous les autres.
Le nombre de câbles augmente donc rapidement : Avec quatre Mac Studio, chaque machine utilise trois ports Thunderbolt pour communiquer avec les trois autres.
Cette organisation permet à n’importe quel Mac d’échanger directement avec tous les autres, sans faire transiter les données par une machine intermédiaire.
Elle explique aussi pourquoi cette architecture devient difficile à étendre. Plus le cluster grandit, plus le nombre de câbles et de ports nécessaires augmente.
Ainsi, un cluster de huit machines nécessiterait ainsi 28 connexions directes, ce qui dépasse rapidement la connectique disponible.
Le RDMA par Thunderbolt convient donc davantage aux petits clusters très rapides qu’aux grandes infrastructures comportant des dizaines de machines.
Combien de câbles pour relier quatre Mac Studio ?
Le nombre de câbles dépend moins du nombre de machines que du mode de communication employé. Une liaison Thunderbolt rapide n’implique pas nécessairement que les échanges utilisent le RDMA.
Option 1 – anneau Thunderbolt : 4 câbles
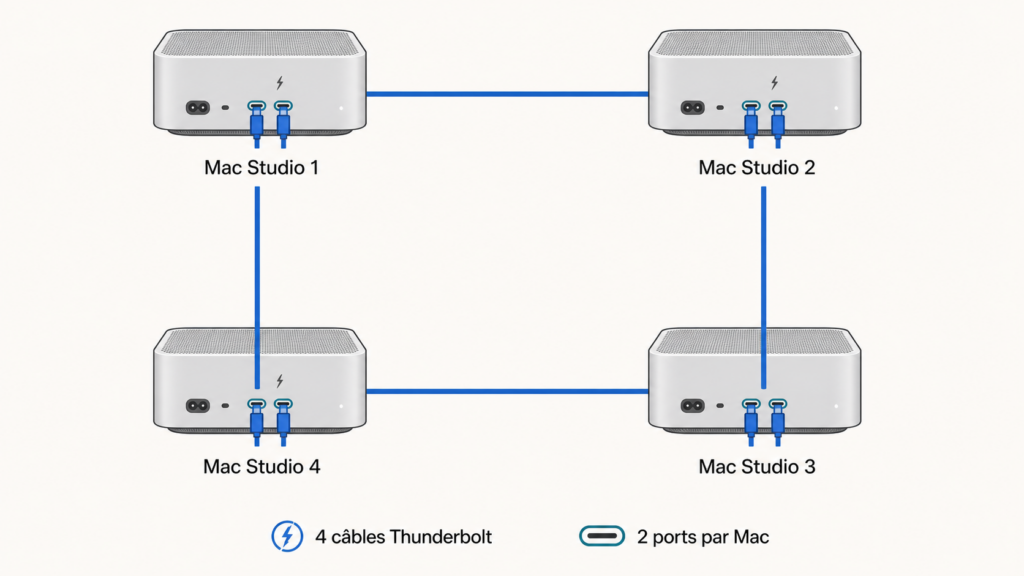
Chaque Mac Studio est relié à deux autres machines afin de former une boucle.
- Nombre de câbles : 4 câbles Thunderbolt
- Ports utilisés : 2 ports par Mac
- Avantage : une installation relativement simple, qui limite le nombre de câbles
- Limite : Il ne s’agit pas du mode RDMA JACCL à faible latence.
Cette topologie peut être pertinente pour certains traitements distribués lorsque la simplicité du câblage compte davantage que la latence minimale.
Option 2 – réseau Ethernet en étoile : 4 câbles
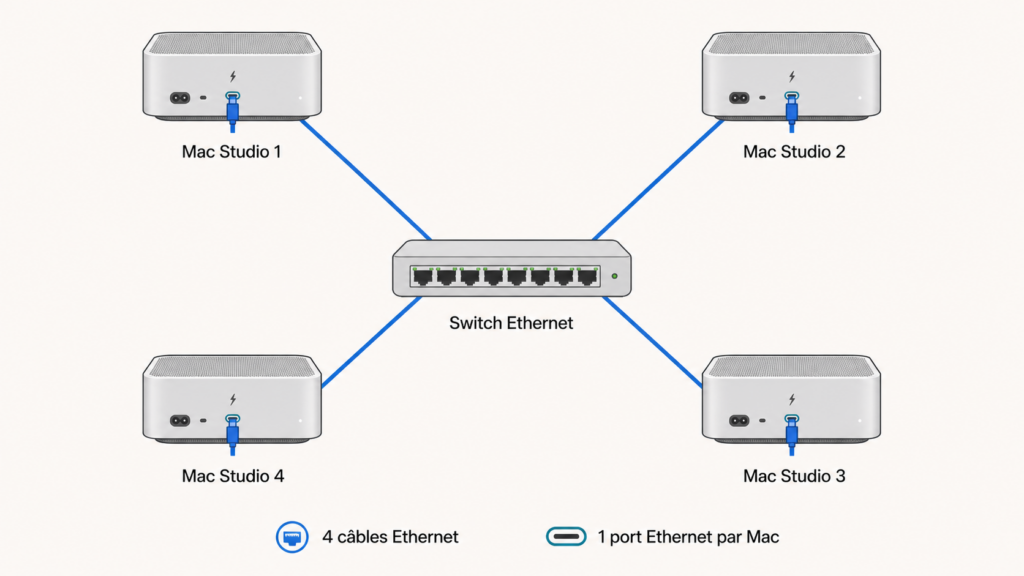
Chaque Mac Studio est connecté à un switch Ethernet central.
- Nombre de câbles : 4 câbles Ethernet.
- Avantage : administration classique, ajout de machines plus simple et possibilité de mutualiser le réseau.
- Limite : le réseau Ethernet 10 Gb/s intégré ne doit pas être présenté comme une liaison RDMA sans matériel et prise en charge explicitement compatibles.
Cette architecture convient aux communications distribuées traditionnelles, mais elle n’offre pas nécessairement les performances du RDMA sur Thunderbolt 5.
Option 3 – maillage Thunderbolt 5 complet : 6 câbles
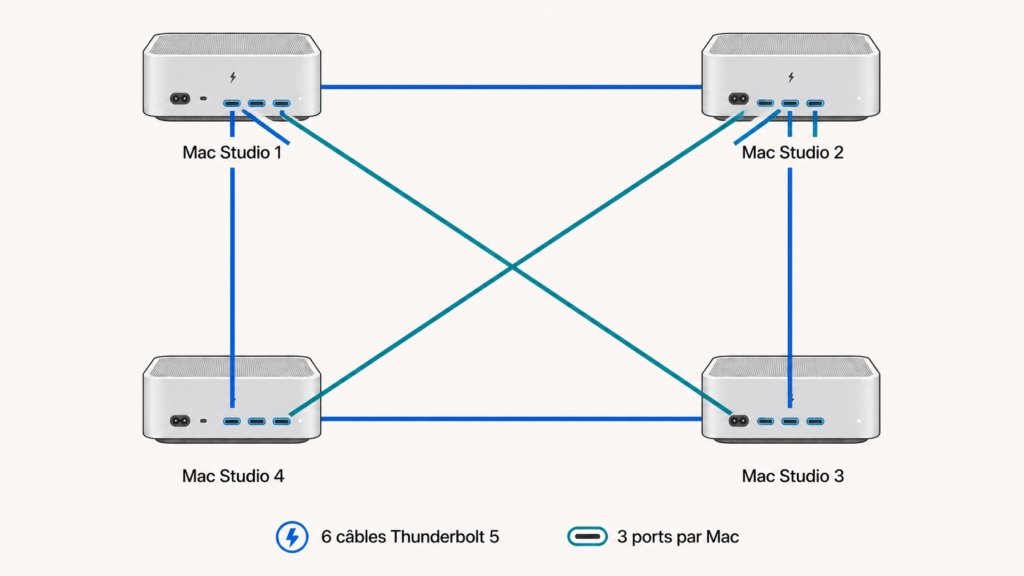
Chaque Mac Studio est directement relié aux trois autres machines. Pour quatre Mac, on aurait ainsi :
- Nombre de câbles : 6 câbles Thunderbolt 5.
- Ports utilisés : 3 ports Thunderbolt par Mac.
- Avantage : chaque paire de machines dispose d’une liaison directe, sans switch intermédiaire.
- Limite : le câblage devient rapidement plus complexe lorsque de nouvelles machines sont ajoutées.
C’est cette topologie entièrement maillée que le backend RDMA JACCL de MLX prend actuellement en charge. Elle est particulièrement adaptée aux charges nécessitant des communications fréquentes et à faible latence entre les machines, notamment certaines formes de parallélisme utilisées pour l’inférence de grands modèles.
Pour quatre Mac Studio, le choix se résume donc essentiellement à un compromis : quatre câbles pour une architecture plus simple en anneau, ou six câbles pour exploiter le maillage RDMA complet sur Thunderbolt 5.
Une configuration encore destinée aux utilisateurs avancés
Le RDMA n’est pas activé comme une simple option dans les réglages de macOS.
La documentation actuelle de MLX demande de démarrer chaque Mac dans l’environnement de récupération, d’ouvrir le Terminal, puis d’activer la fonction avec l’outil prévu par Apple.
Après le redémarrage, les connexions doivent être vérifiées et les interfaces Thunderbolt configurées.
Il ne suffit donc pas de brancher deux câbles et de lancer une application pour voir apparaître un Mac deux fois plus puissant.
Quatre Mac Studio ne sont pas quatre fois plus rapides
Apple annonce qu’un cluster de quatre Mac Studio peut atteindre jusqu’à trois fois les performances d’une seule machine pour certaines opérations d’inférence distribuée.
Ce résultat représente une accélération importante, mais pas une multiplication parfaite.
Avec quatre machines, un gain maximal de trois correspond à une efficacité de mise à l’échelle d’environ 75 %. Le quart de la puissance théorique supplémentaire est absorbé par les communications, les synchronisations et les parties du programme qui ne peuvent pas être réparties.
Cette perte est normale dans un système distribué.
Plusieurs facteurs peuvent limiter les performances :
- La fréquence des échanges entre les machines
- La taille des données transférées
- La façon dont le modèle est découpé
- Les différences de charge entre les Mac
- Les phases qui restent séquentielles
- Le temps nécessaire pour regrouper les résultats
- Les limites du moteur d’inférence.
Certains modèles se répartissent plus facilement que d’autres. Les architectures comportant des experts spécialisés peuvent, par exemple, permettre de placer différents groupes de paramètres sur différentes machines.
D’autres modèles demandent des échanges constants entre toutes leurs couches et profiteront moins efficacement du cluster.
Le principal avantage reste la capacité
La vitesse attire naturellement l’attention, mais le principal intérêt du RDMA pourrait être la possibilité de charger des modèles beaucoup plus grands.
Un Mac Studio M5 Ultra peut recevoir jusqu’à 512 Go de mémoire unifiée. Quatre machines représentent jusqu’à 2 To de mémoire physique cumulée.
Toute cette mémoire n’est pas accessible avec la vitesse de la mémoire locale, mais elle permet de répartir des modèles qui ne pourraient pas tenir sur une seule machine.
Avec un tel cluster, certains cas d’usage demandant auparavant une capacité de mise en oeuvre complexe deviennent désormais la norme (sous réserve de disposer de telles machines). Ainsi, par exemple, exécuter de très grands modèles ouverts, expérimenter des modèles de comportement conséquents (plusieurs centaines de milliards de paramètres) deviennent désormais exploitables.
Cette capacité peut intéresser les laboratoires, les entreprises, les universités et les équipes travaillant avec des données confidentielles.
Pour un utilisateur individuel, l’achat de plusieurs Mac Studio restera difficile à justifier. Les coûts du matériel, du stockage, de l’alimentation et de l’administration doivent être comparés aux offres cloud et aux serveurs équipés de GPU spécialisés.
RDMA ou Ethernet 10 Gbit/s ?
Les Mac Studio disposent également d’un port Ethernet 10 Gbit/s. Il est donc légitime de se demander pourquoi Thunderbolt 5 et RDMA sont nécessaires.
L’Ethernet conserve plusieurs avantages, tels que l’utilisation d’équipements réseau standards, son câblage simplifié et surtout, il permet de relier davantage de machines.
Le RDMA par Thunderbolt vise un autre besoin : les communications très fréquentes et sensibles à la latence.
Dans un cluster de Mac, Ethernet peut servir à l’administration et aux connexions SSH, tandis que Thunderbolt et le RDMA transportent les données nécessaires aux calculs.
Les deux technologies sont donc complémentaires.
À quels utilisateurs cette technologie s’adresse-t-elle ?
Le RDMA ne transformera pas l’utilisation quotidienne d’un Mac. Il n’accélérera ni Safari, ni la bureautique, ni une application qui ne sait pas répartir son travail.
Les principaux utilisateurs concernés seront :
Les chercheurs en intelligence artificielle
Ils pourront expérimenter avec des modèles trop volumineux pour une seule machine et conserver leurs données localement.
Les développeurs de moteurs d’inférence
Ils pourront étudier de nouvelles méthodes de parallélisme, optimiser les communications et adapter leurs logiciels à l’architecture Apple Silicon.
Les entreprises manipulant des données sensibles
Un cluster local peut limiter l’envoi de documents, de code ou de données confidentielles vers des services cloud.
Les laboratoires et universités
Plusieurs Mac peuvent constituer une plateforme relativement compacte pour l’enseignement et l’expérimentation en calcul distribué.
Les studios et professionnels de la création
Le RDMA pourrait aussi servir à certaines opérations de rendu, de simulation ou de traitement distribué, à condition que les applications professionnelles ajoutent une prise en charge adaptée.
Une alternative aux clusters de GPU Nvidia ?
Le rapprochement est inévitable. Les clusters de GPU Nvidia utilisent depuis longtemps des technologies comme RDMA, InfiniBand(5) et NCCL(4) pour répartir leurs calculs.
Apple tente de proposer une approche plus compacte avec Thunderbolt 5, MLX et la mémoire unifiée de ses puces.
Les Mac disposent d’un avantage particulier : leur capacité mémoire. Un Mac Studio peut recevoir jusqu’à 512 Go, alors qu’une carte graphique dédiée dispose généralement de beaucoup moins de mémoire vidéo.
Les solutions Nvidia conservent néanmoins plusieurs atouts :
- Une puissance de calcul souvent supérieure
- Un écosystème CUDA très développé
- Des bibliothèques distribuées matures
- Des interconnexions spécialisées
- Une large compatibilité avec les outils de recherche
- Des solutions conçues pour de très grands clusters.
Le cluster de Mac ne remplace donc pas directement une infrastructure Nvidia. Il propose un compromis différent : beaucoup de mémoire locale, une faible consommation, un fonctionnement silencieux et un environnement relativement compact.
Son intérêt dépendra davantage de la capacité à exécuter certains modèles que de la recherche de la puissance brute maximale.
Et le Mac Mini ?
Le Mac mini peut également intégrer un cluster RDMA, à condition de choisir un modèle équipé de Thunderbolt 5.
Dans la gamme actuelle, cette possibilité concerne le Mac mini M5 Pro, qui possède trois ports Thunderbolt 5 à l’arrière. Le Mac mini M6 standard, limité au Thunderbolt 4, ne répond pas aux prérequis du RDMA sur Thunderbolt définis par Apple (voir mon article sur les nouveaux Mac Mini)
Les règles de câblage sont alors identiques à celles du Mac Studio :
- Deux Mac mini nécessitent un câble Thunderbolt 5
- Trois Mac mini en maillage complet nécessitent trois câbles
- Quatre Mac mini en maillage complet nécessitent six câbles.
Avec ses trois ports Thunderbolt 5, chaque Mac mini M5 Pro peut être directement relié aux trois autres machines d’un cluster composé de quatre nœuds.
Pour conclure
Le RDMA par Thunderbolt 5 donne aux Mac une fonction autrefois réservée aux serveurs et aux stations spécialisées : la possibilité d’échanger rapidement des données pour effectuer un calcul distribué.
La technologie réduit la latence et les interventions du processeur, mais elle ne fusionne pas réellement les mémoires. Chaque Mac conserve ses propres ressources et les logiciels doivent organiser soigneusement la répartition des données.
Le principal avantage n’est peut-être pas de rendre quatre machines quatre fois plus rapides. Il consiste surtout à pouvoir charger et exécuter des modèles qui dépassent la capacité d’un seul ordinateur.
Avec MLX et JACCL, Apple dispose désormais des premières briques nécessaires à la création de petits clusters de Mac. La mise en place reste complexe, le nombre de câbles augmente rapidement et les logiciels compatibles sont encore peu nombreux.
Cette technologie ne concernera donc pas la majorité des utilisateurs. Elle peut en revanche devenir très intéressante pour les chercheurs, les développeurs et les entreprises souhaitant disposer d’une infrastructure d’intelligence artificielle locale, compacte et capable d’accueillir plusieurs téraoctets de mémoire.
Sources
- Communication à faible latence avec RDMA sur Thunderbolt — Apple Developer.
- Documentation MLX consacrée au calcul distribué et à JACCL — MLX.
- Configuration et lancement de programmes MLX distribués — MLX.
- Présentation du Mac Studio M5 Max et M5 Ultra — Apple Newsroom.
- MLX LM : exécution de grands modèles de langage avec MLX — MLX.
- Mon article sur les nouveaux Mac Studio
(1) JACCL : Jack and Angelos’ Collective Communication Library – Bibliothèque de communication collective d’Apple conçue pour le calcul distribué via RDMA (Remote Direct Memory Access) sur Thunderbolt
(2) RING : Architecture réseau en boucle permettant à plusieurs serveurs ou GPU d’échanger des données directement de mémoire à mémoire sans passer par le processeur, maximisant ainsi la vitesse de calcul, en Ethernet ou Thunderbolt
(3) NPI : Network Programming Interface – Architecture logicielle standardisée qui relie les applications ou le système d’exploitation à la carte réseau pour permettre l’exécution directe des commandes RDMA à haute vitesse.
(4) NCCL : NVIDIA Collective Communications Library – Bibliothèque logicielle de NVIDIA optimisant l’échange de données entre plusieurs processeurs graphiques (GPU) afin d’accélérer l’entraînement des intelligences artificielles et le calcul intensif.
(5) InfiniBand : Norme de réseau et d’interconnexion à très haute vitesse et ultra-faible latence