Ce 25 août, Apple a dévoilé son nouveau Mac Mini. Au programme : Nouveaux CPUs et nouveaux tarifs.
Le Mac mini conserve son format minuscule, mais Apple semble vouloir lui donner un rôle beaucoup plus ambitieux. Avec les puces M6 et M5 Pro, il ne s’agit plus seulement d’un ordinateur de bureau compact : La version M4 nous l’a démontré : Le Mac Mini peut aussi faire office de petit serveur capable d’héberger des modèles d’intelligence artificielle et des agents fonctionnant en permanence.
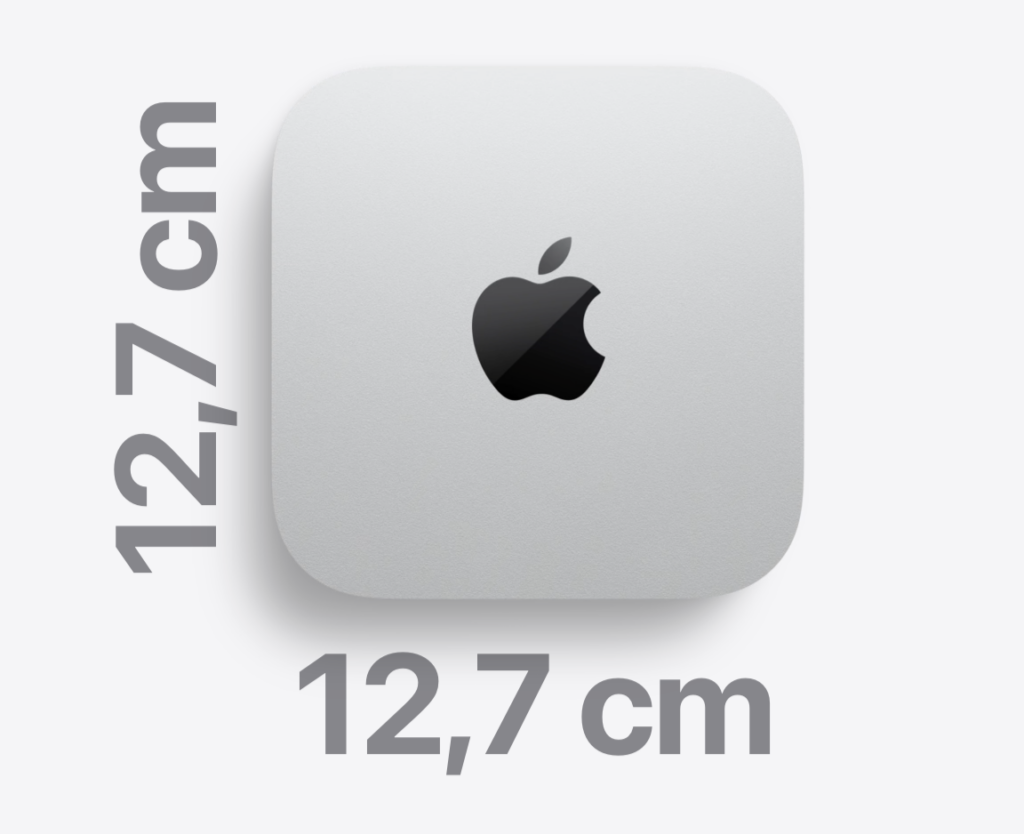
C’est cette évolution qui m’intéresse ici. L’arrivée des puces M6 et M5 Pro dans ce Mac Mini attirent naturellement l’attention, mais ils ne suffisent pas à déterminer les performances réelles d’un modèle local. La quantité de mémoire, sa bande passante et la compatibilité des logiciels restent tout aussi importantes.
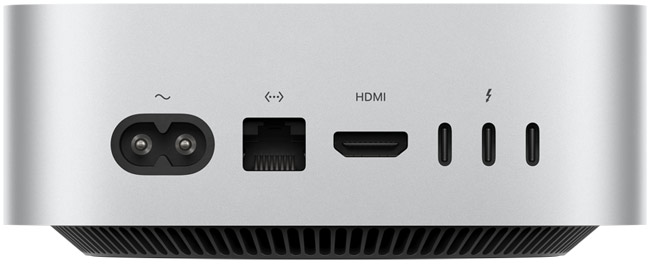
Apple accompagne donc ces nouvelles puces de plusieurs évolutions : une bande passante mémoire revue à la hausse (sauf sur le modèle M6 équipé de 16 Go), de l’Ethernet 2,5 Gbit/s de série et trois ports Thunderbolt 5 sur le modèle M5 Pro. Ce dernier peut notamment relier plusieurs Mac pour des usages distribués (d’ailleurs ce sujet mérite un article !)
En bref
- Le Mac mini M6 introduit de nouveaux accélérateurs spécialisés dans les calculs matriciels utilisés par l’IA.
- Le modèle équipé de 16 Go conviendra surtout aux petits modèles quantifiés.
- Une configuration de 24 ou 32 Go offrira davantage de souplesse pour l’IA locale.
- Le modèle M5 Pro reste nettement mieux armé pour les grands modèles grâce à ses 48 ou 64 Go de mémoire et à sa bande passante de 307 Go/s.
Deux Mac mini techniquement très différents
Les versions M6 et M5 Pro partagent le même boîtier, mais elles ne répondent pas exactement aux mêmes besoins.
Le Mac mini M6 privilégie l’efficacité énergétique et l’accès aux nouveaux accélérateurs graphiques. Le M5 Pro mise plutôt sur la puissance brute, une quantité de mémoire supérieure et une bande passante presque deux fois plus élevée.
| Caractéristique | Mac mini M6 | Mac mini M5 Pro |
| CPU | 12 coeurs | 15 ou 18 coeurs |
| GPU | 12 coeurs | 16 ou 20 coeurs |
| Mémoire unifiée | 16 à 32Go | 24 à 64Go |
| Bande passante | 153 ou 170Go/s | 307Go/s |
| Stockage | 256Go à 2To | 512Go à 8To |
| Ports avant | 2 ports USB-C, prise casque 3,5mm | 2 ports USB-C, prise casque 3,5mm |
| Ports arrière | 3 x Thunderbolt 4 | 3 x Thunderbolt 5 |
| Ethernet | 2,5Gb/s, 10Gb/s en option | 2,5Gb/s, 10Gb/s en option |
| Prix de départ | 1 049€ | 1 999€ |
La puce M6 possède un CPU de 12 cœurs composé de deux « super cœurs », quatre cœurs de performance et six cœurs à haute efficacité énergétique. Son GPU compte 12 cœurs. La puce M5 Pro abandonne les cœurs économes pour se concentrer sur la puissance, avec cinq super cœurs et dix cœurs de performance dans sa configuration de base.
Un « super cœur » désigne ici le cœur CPU le plus rapide de la puce. Il intervient notamment dans les tâches difficiles à répartir entre plusieurs cœurs : lancement d’une application, navigation dans une interface ou certaines phases de compilation. Les autres cœurs de performance prennent ensuite le relais lorsque le travail peut être parallélisé.
Le numéro de génération ne raconte donc pas toute l’histoire. La puce M6 est plus récente, mais la puce M5 Pro possède davantage de cœurs rapides, presque deux fois plus de bande passante mémoire et peut recevoir deux fois plus de mémoire. Pour les travaux lourds, elle reste largement supérieure.
Trois moteurs de calcul pour l’intelligence artificielle
Sur un Mac, l’intelligence artificielle ne repose pas sur un composant unique. Une application peut exploiter le CPU, le GPU ou le Neural Engine selon la nature des calculs et les technologies qu’elle utilise.
Le CPU reste le composant le plus polyvalent, mais il n’est pas nécessairement le plus efficace pour multiplier les immenses matrices utilisées par les réseaux neuronaux.
Le Neural Engine est spécialisé dans les opérations d’apprentissage automatique économes en énergie. macOS, Apple Intelligence, Core ML et certaines applications optimisées peuvent notamment l’utiliser.
Le GPU dispose, quant à lui, d’un parallélisme beaucoup plus important. Il est particulièrement efficace pour répéter une même opération sur de grands tableaux de nombres. Avec ces nouvelles puces, chaque cœur graphique reçoit également un Neural Accelerator spécialisé dans les multiplications matricielles.
C’est probablement là que se trouve l’évolution la plus importante. Apple annonce un traitement des prompts jusqu’à 4,8 fois plus rapide dans LM Studio avec la puce M6 qu’avec la puce M4. Ce chiffre demande toutefois à être interprété avec prudence : il ne signifie pas que toutes les applications, ni même toutes les étapes d’une génération, seront 4,8 fois plus rapides.
Les gains les plus importants concerneront les logiciels capables d’exploiter correctement ces nouveaux accélérateurs. Leur présence dans la puce ne garantit donc pas, à elle seule, une amélioration immédiate. Il faudra observer les mises à jour de Metal, MLX, Core ML et des différents moteurs d’inférence, puis attendre de véritables essais indépendants.
Traitement du prompt et génération : deux mesures différentes
Je me permets ici une petite parenthèse technique pour expliquer ce qui se passe lorsqu’un prompt est envoyé à un modèle d’intelligence artificielle.
Le chiffre de 4,8 avancé par Apple concerne le prompt processing, c’est-à-dire l’analyse initiale du texte envoyé au modèle. Cette étape, souvent appelée prefill, peut traiter simultanément un grand nombre de tokens. Elle profite donc particulièrement des nouvelles unités capables d’effectuer des calculs matriciels en parallèle.
La génération de la réponse suit une autre logique. Le modèle produit un token, réutilise le résultat obtenu, puis calcule le suivant. Cette phase de décodage est plus séquentielle et dépend fortement de la vitesse à laquelle les poids du modèle sont lus depuis la mémoire.
Un prompt traité 4,8 fois plus rapidement ne signifie donc pas que les mots apparaîtront 4,8 fois plus vite pendant toute la réponse.
Pour évaluer correctement les performances d’un Mac en IA locale, il faudra mesurer plusieurs éléments séparément :
- Le nombre de tokens de prompt analysés par seconde
- Le nombre de nouveaux tokens générés par seconde
- Le temps nécessaire avant l’apparition du premier token
- Les performances avec plusieurs requêtes simultanées
- La consommation électrique pendant une longue session
Cette distinction devient encore plus importante avec les agents. Leur travail ne se limite pas à générer du texte : ils doivent aussi appeler des outils, consulter des documents, exécuter des programmes et interpréter les résultats. Leur efficacité globale dépend donc de toute la chaîne, pas uniquement de la vitesse brute du modèle.
La mémoire détermine quels modèles peuvent fonctionner
La mémoire unifiée constitue l’un des principaux atouts des puces Apple pour l’IA locale. Le CPU et le GPU accèdent au même ensemble de mémoire, sans devoir copier continuellement les données entre la RAM principale et la mémoire vidéo d’une carte graphique séparée.
Cette architecture simplifie les échanges, mais elle ne rend évidemment pas la mémoire illimitée.
Un modèle de huit milliards de paramètres occupe théoriquement environ 16 Go lorsque ses poids sont stockés en 16 bits. Une quantification en 8 bits ramène cette valeur autour de 8 Go, tandis qu’une quantification en 4 bits la réduit à environ 4 Go.
Il faut cependant ajouter le moteur d’inférence, macOS, les autres applications, les espaces de travail temporaires et le cache KV utilisé pour conserver le contexte de la conversation.
| Taille du modèle | Poids théoriques en 4 bits | Configuration raisonnable |
| 8 milliards de paramètres | environ 4 Go | 16 Go ou plus |
| 14 milliards | environ 7 Go | 24 Go ou plus |
| 32 milliards | environ 16 Go | 24 à 32 Go |
| 70 milliards | environ 35 Go | 48 à 64 Go |
Ces valeurs restent des estimations. Les fichiers comportent des métadonnées et certaines parties peuvent conserver une précision supérieure à 4 bits. La taille du cache KV augmente également avec la longueur du contexte.
Dans la pratique, le Mac mini M6 équipé de 16 Go conviendra surtout aux petits modèles quantifiés. Il risque d’atteindre rapidement ses limites si plusieurs applications ou services doivent fonctionner en parallèle.
Avec 24 ou 32 Go, la machine devient beaucoup plus souple pour les modèles intermédiaires. Les modèles approchant 70 milliards de paramètres resteront plutôt réservés au M5 Pro doté de 48 ou 64 Go, avec une quantification importante et suffisamment de mémoire laissée au système.
Pour information, le terme « cache KV » signifie « Key-Value Cache ». Il s’agit d’une technique d’optimisation qui conserve certaines données associées aux tokens précédents afin d’accélérer la génération du texte.
La bande passante compte presque autant que la capacité
La capacité indique si un modèle peut entrer en mémoire. La bande passante influence la vitesse à laquelle ses poids peuvent être lus.
Le Mac mini M6 offre 153 Go/s de bande passante avec 16 Go de mémoire, puis 170 Go/s avec 24 ou 32 Go. La configuration 24 Go n’ajoute donc pas seulement de la capacité : elle augmente aussi la bande passante d’environ 11 %.
La puce M5 Pro atteint 307 Go/s, soit environ 1,8 fois la bande passante maximale de la puce M6.
Lors de la génération d’un token, un grand modèle doit parcourir une partie importante de ses poids. Une estimation très simplifiée de la limite maximale peut être obtenue en divisant la bande passante par la taille du modèle en mémoire.
Un modèle occupant 18 Go sur une puce M6 à 170 Go/s donne ainsi une limite théorique inférieure à 10 parcours complets par seconde. Un modèle de 36 Go sur une puce M5 Pro à 307 Go/s se situe dans le même ordre de grandeur.
Ce calcul ne constitue pas un benchmark. Il ignore les caches, les pertes d’efficacité, l’architecture exacte du modèle et le travail supplémentaire nécessaire à chaque token. Il montre cependant pourquoi doubler le nombre de cœurs GPU ne suffit pas toujours : si les unités de calcul attendent les données, la mémoire devient le goulet d’étranglement.
M6 ou M5 Pro pour l’IA locale ?
Le Mac mini M6 semble être la proposition la plus accessible pour expérimenter avec l’IA locale. Il bénéficie des nouveaux accélérateurs GPU, consomme peu et peut faire fonctionner de petits modèles sans connexion au cloud.
La configuration de base, limitée à 16 Go de mémoire et 256 Go de stockage, présente toutefois deux contraintes importantes. La mémoire laissera peu de marge pour exécuter simultanément un modèle, un agent et plusieurs applications. Quant au SSD, il peut rapidement se remplir : une collection de modèles quantifiés représente facilement plusieurs centaines de gigaoctets.
À mon sens, la configuration de 24 Go constitue un point de départ plus cohérent pour une machine réellement destinée à l’IA locale. Elle offre davantage de mémoire et une bande passante légèrement supérieure. Un SSD externe rapide pourra compléter le stockage interne, même si les modèles devront toujours être chargés en mémoire pour être utilisés.
Le M5 Pro répond à un besoin différent. Ses configurations de 48 ou 64 Go peuvent accueillir des modèles beaucoup plus volumineux, tandis que sa bande passante de 307 Go/s devrait améliorer la vitesse de génération. Ses cœurs CPU supplémentaires seront également utiles pour compiler du code, traiter de la vidéo, effectuer des simulations ou faire fonctionner plusieurs services en parallèle.
Il faudra néanmoins comparer attentivement son prix final avec celui du Mac Studio M5 Max. Une configuration M5 Pro fortement équipée peut s’en rapprocher, alors que le Mac Studio propose jusqu’à 128 Go de mémoire et un GPU plus imposant.
Thunderbolt 5 : Beaucoup plus qu’un port rapide
Le Mac mini M6 conserve trois ports Thunderbolt 4, capables d’atteindre 40 Gbit/s. Le modèle M5 Pro adopte trois ports Thunderbolt 5 pouvant monter jusqu’à 120 Gbit/s dans certains modes.
Ce débit supplémentaire profitera aux SSD externes, aux stations d’accueil, aux interfaces vidéo et aux châssis d’extension. Le M5 Pro peut également piloter trois écrans 6K à 60 Hz et transmettre trois flux vidéo depuis un même port Thunderbolt 5.
Apple met aussi en avant la possibilité de relier plusieurs Mac mini afin de répartir un modèle d’intelligence artificielle. L’idée est séduisante, mais elle mérite une précision importante : connecter plusieurs machines ne crée pas une immense mémoire unifiée.
Le modèle doit être réparti entre les ordinateurs. À chaque étape du calcul, les machines doivent échanger des données et se synchroniser. Même avec Thunderbolt 5, cette liaison reste beaucoup plus lente que les 307 Go/s offerts par la mémoire locale du M5 Pro.
Un ensemble de deux Mac mini ne sera donc pas automatiquement deux fois plus rapide. Il pourrait même perdre en efficacité si le logiciel répartit mal le modèle ou si les communications prennent une place trop importante. Le principal intérêt d’un tel montage sera plutôt de charger un modèle qui ne pourrait pas tenir dans une seule machine.
Wi‑Fi 7, Bluetooth 6, Thread et Genlock
Les deux modèles adoptent une puce réseau Apple N1 compatible avec le Wi‑Fi 7, le Bluetooth 6 et Thread.
Le Wi‑Fi 7 peut améliorer le débit, la latence et la gestion de plusieurs bandes de fréquences, à condition d’utiliser un point d’accès compatible. Pour une machine fixe ou un serveur, l’Ethernet conservera néanmoins plusieurs avantages : débit plus stable, latence prévisible et moindre sensibilité aux interférences.
La présence de Thread est intéressante pour la domotique. Elle permet au Mac mini de communiquer avec certains appareils utilisant ce protocole maillé et basse consommation. Apple ne précise toutefois pas que le Mac mini peut remplacer à lui seul toutes les fonctions d’un routeur de bordure Thread ou d’un concentrateur domotique.
La prise en charge du Genlock est également une belle surprise pour intéressés : Cette fonction synchronise plusieurs appareils vidéo, évitant les dérives d’horloge et assurant un début d’image simultané. Essentielle pour la captation multicaméra, les murs LED, le direct et la production virtuelle, elle prévient les bandes, le scintillement et les images partiellement renouvelées. Bien que peu d’utilisateurs l’achètent pour cette fonction, elle témoigne de la volonté d’Apple d’intégrer le Mac mini dans des environnements professionnels.
Pour conclure
Le Mac mini M6 de base reste extrêmement puissant compte tenu de son encombrement. Il pourra servir de poste bureautique, de machine de développement, de station de création légère, de serveur domestique ou de plateforme pour découvrir l’IA locale.
Pour un usage régulier avec des modèles locaux, je choisirais néanmoins la configuration de 24 Go. Elle laisse davantage de marge, profite d’une bande passante légèrement supérieure et devrait rester polyvalente plus longtemps. Le stockage interne pourra être complété par un SSD externe rapide.
Le M5 Pro devient pertinent lorsque la mémoire, la bande passante ou les performances multithread constituent de véritables contraintes. Les configurations de 48 et 64 Go sont les mieux adaptées aux modèles plus lourds et à l’exécution simultanée de plusieurs services.
Cette génération révèle surtout la nouvelle place du Mac mini dans la gamme Apple : Il devient une petite machine modulaire, capable d’évoluer du simple poste de travail vers le serveur domestique, l’agent local ou, dans certains cas, un élément d’une infrastructure distribuée.
Sources
- Communiqué de lancement du Mac mini publié par Apple.
- Fiche technique du Mac mini publiée par Apple.
- Documentation Apple consacrée à Metal, MLX et Core ML.
- Documentation des moteurs d’inférence utilisés pour les mesures de performances : LM Studio et MLX LM